一天 300 条咨询,账单上只剩一行
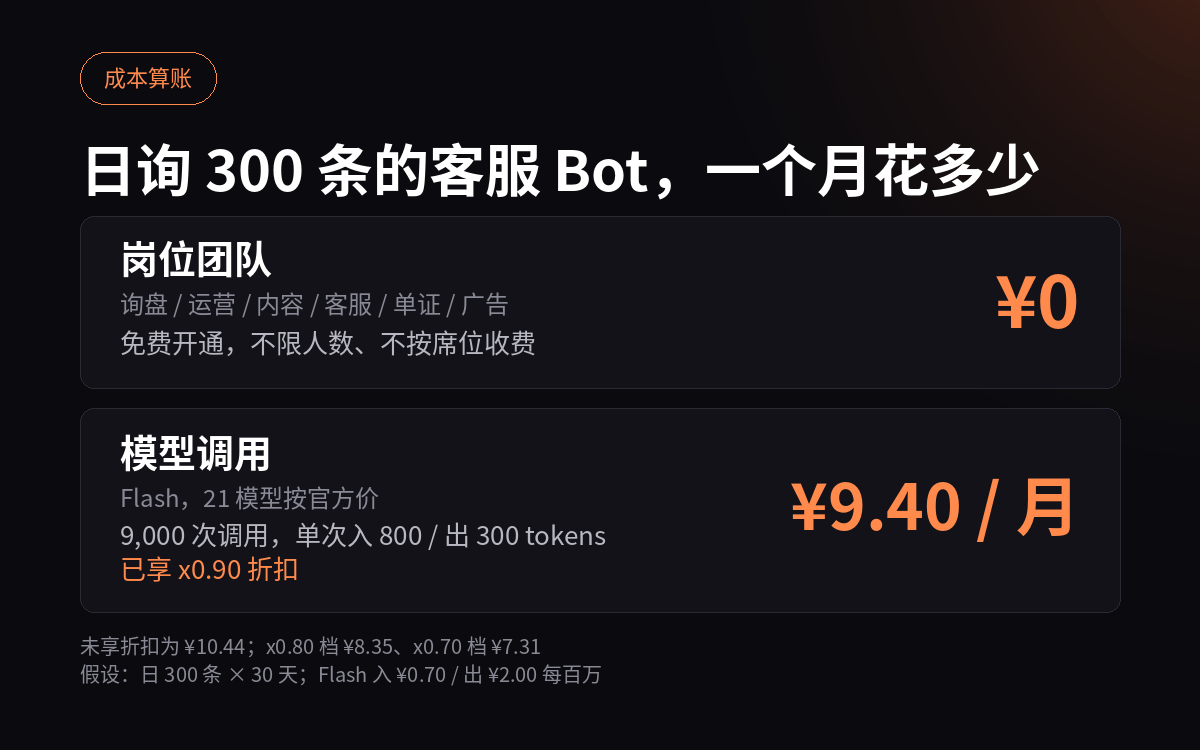
先给答案:日询 300 条的客服 Bot,一个月模型调用费是 ¥9.40。不是 ¥9,400,是九块四。固定支出那一栏已经没有了,账上只剩 token 一行。
把假设写清楚,你可以把自己的数代进去:日咨询量 300 条;单条输入 ≈ 800 tokens(客户消息 + 历史对话 + 指令);单条输出 ≈ 300 tokens;按 30 天算。
四个数一换,金额跟着换。但换完你会发现:能动的只有 token 这一行,而它由上下文长度和单价决定,跟你选哪一档的折扣关系不大。
成本拆解:固定月费那一栏删掉之后
只有一笔钱:token
过去算 AI 客服的月账,要分「固定月费 + 变动 token」两栏。现在只剩一栏:模型调用从账户余额按实际用量扣,单价以官方价为锚点、随累计充值档位打折;岗位团队免费开通,渠道接入不额外收费。
于是「钱花在哪」这个问法也变了。它不再是一个固定数与一个变动数比大小,而是一个乘法:处理量 × 单条上下文长度 × 单价,再乘你的折扣系数。
按现役单价算,300 条/日 这个量级的月费是个位数:¥10.44 / ¥9.40 / ¥8.35 / ¥7.31,四行分别是官方价与三档折后价,后面逐行给算式。
真正决定金额的是上下文长度,不是档位
四档之间,最贵和最便宜差 ¥3.13。同一个量级里,这个差额小于你多塞两轮对话造成的影响。
量级感可以这样拿:单条输入从 800 涨到 8,000 tokens(比如把整份产品目录、历史工单全塞进上下文),月费就从 ¥9.40 变成 ¥50.22——输入 72 百万 × 0.63 = 45.36,输出 2.7 百万 × 1.80 = 4.86。要到三位数,单条输入得再涨到约 32,000 tokens:288 百万 × 0.63 + 2.7 百万 × 1.80 ≈ ¥186.30。
所以优化上下文比优化档位有用得多:截掉用不上的历史消息、把产品线收窄到客户当前问的那几款,压下去的是十倍量级;盯着折扣档抠,抠出来的是百分之十。
岗位团队免费开通:定的是归属与权限
岗位团队免费开通,不限人数、不按席位收费,只按 token 用量计费;私有化部署与本地模型走企业微信人工定制。岗位按业务划分(询盘、运营、内容、客服、单证、广告),成员可多人登录协作,谁能改配置、几个 Bot 怎么分权,团队与权限写得比这篇细。
这句解决的是归属问题,不是费用问题:一个客服 Bot 挂在哪几条渠道、谁能改它的指令、它能碰哪些数据、出问题找谁,都在岗位里定死。它不产生月费,所以也不必拿来跟 token 比大小。
折扣档换的是单价,不是能不能用
累计充值三档:¥0–1,000 → x0.90–0.933;¥1,000–5,000 → x0.80–0.867;¥5,000+ → x0.70–0.80。三档同为 600 RPM,21 个模型全开,以官方价为锚点,按实际用量从余额扣。
折扣只影响你为同样 token 付多少钱,不影响 Bot 能不能跑、跑多快。
所以「要不要先充到下一档」该问的是:我的月用量值不值得为那 10% 提前压一笔钱进去。对日询 300 条这种量级,答案通常是不值得——先把岗位跑稳,量真上来了再说;算不准的话,联系我们核一遍再充。
方案:先接一条渠道跑通,再谈编排
落地顺序比选模型重要。三步,别跳:
- 接一条渠道。 企微、WhatsApp、Telegram、邮件、Slack 都行,先挑你 80% 询盘进来的那一条。渠道接入与授权见渠道与接入说明。
- 写死一条硬规则。 不确定就转人工,转人工只能由人来判断这条规则本身要不要改。
- 看三天账单。 用量和余额在哪看,见计费与账单说明——按实际用量从余额扣,没有打包额度要清。
触发方式不用自己造轮子:计划、Webhook、邮件事件、关注的变化,四种够覆盖客服场景。
模型路由只记三句:日常分拣、摘要、批量回复走 Doitx-3.0-Flash;写作、决策、审批与视觉识别走 Doitx-3.0-Pro;图像理解与视频分镜逆推走 Doitx-VL。客服 Bot 里绝大多数消息是 Flash 该干的活,把 Pro 留给它真正该做的判断。
证据:四个档位的月账,逐行算给你复算
前提还是那四个假设:日 300 条、单条输入 800 tokens、单条输出 300 tokens、按 30 天。先算量:
日输入 = 300 × 800 = 240,000 tokens
日输出 = 300 × 300 = 90,000 tokens
月输入 = 240,000 × 30 = 7,200,000 tokens = 7.2(百万)
月输出 = 90,000  × 30 = 2,700,000 tokens = 2.7(百万)
再乘单价。单价表统一用”元/百万 tokens”,本文不混用”每千”,一个单位算到底:
| Doitx-3.0-Flash | 输入单价 | 输出单价 | 月输入费 | 月输出费 | 月合计 |
|---|---|---|---|---|---|
| 官方价 | 0.70 | 2.00 | 5.04 | 5.40 | 10.44 |
| 基础档 | 0.63 | 1.80 | 4.54 | 4.86 | 9.40 |
| 专业档 | 0.56 | 1.60 | 4.03 | 4.32 | 8.35 |
| 尊享档 | 0.49 | 1.40 | 3.53 | 3.78 | 7.31 |
官方价那一行是三档之外的原价,列出来是为了让你看到折扣到底折掉了多少:和尊享档比,差 ¥3.13。
基础档的算式摊开是这样,其余三行同法:
7.2 × 0.63 + 2.7 × 1.80 = 4.536 + 4.86 = 9.396 ≈ ¥9.40换个数校验: 7.2 × 0.70 = 5.04,2.7 × 2.00 = 5.40,相加 10.44,与上表官方价一行对得上;基础档在官方价上按 ×0.90 折算,4.54 + 4.86 = 9.40。全程一个单位算到底,账就对得上。
绝对额摆完,再给一句判断依据:这笔钱该不该管,看它在什么量级。¥9.40 是一个月的模型调用费;同样的活交给一个客服,是一个岗位的月薪。两者不在一个量级,真正该盯的不是”token 花了多少”,而是”上下文有没有白塞”。
第二个算式:内容岗位比客服更便宜
同一套方法换到内容岗。假设每月 12 次长任务,每次输入 180,000 tokens、输出 90,000 tokens(写稿、审稿、整理素材,一次上下文差不多就是这个量级):
月输入 = 12 × 180,000 = 2,160,000 tokens = 2.16(百万)
月输出 = 12 × 90,000  = 1,080,000 tokens = 1.08(百万)
Pro 基础档 = 2.16 × 0.99 + 1.08 × 3.94 = 2.138 + 4.255 ≈ ¥6.39
一个提醒:Pro 分时段计价。非高峰是输入 ¥1.09 / 输出 ¥4.38,高峰是输入 ¥1.97 / 输出 ¥7.88(均为元/百万 tokens)。同一笔量按高峰价算是 2.16 × 1.97 + 1.08 × 7.88 ≈ ¥12.77,差不多是非高峰那个数的两倍。批量任务排到非高峰,这笔能压回一半附近。
三个最常被追问的问题
注册赠的 500 万 tokens 能用多久?
没有通用天数:取决于走哪个模型、输入输出各占多少。正文那张四档表是在它的假设下算的,换一个量就换一个结果,量轻的场景能跑得更久。这 500 万注册即赠、不设到期日,用不完也不会消失。
加量包还便宜吗?
可以随时买,没有独立的固定折扣。它的价格按你购买当时所在的累计充值档位折算,并且这笔钱计入累计充值金额,继续把你往下一档推。所以「现在买还是攒着买」的区别,只在于买的当下站在哪一档。它的定义现在只写在团队与权限那页,价格页已不提这一项。
咨询量翻三倍会被限速吗?
不会。三档同为 600 RPM,21 个模型全开,升级换的是单价不是速率。所以旺季前不必为了「怕卡」提前充到高档:咨询量翻几倍该先调的是上下文长度和转人工规则,这两项不花钱,先把它们调对。
想按自己的日咨询量算一遍
本文每个数字都出自价格页那张表(21 个模型、官方价与三档折后价);计费口径、试用额度、私有化部署这几类问法,计费常见问题里逐条写了。
下一步只做一件事:打开价格页,把你自己的日咨询量代进上面那行算式,先算出属于你的那个数。
2026-11-13 更新:岗位团队改为免费开通,计费口径已调整。